Categoria: AI
-
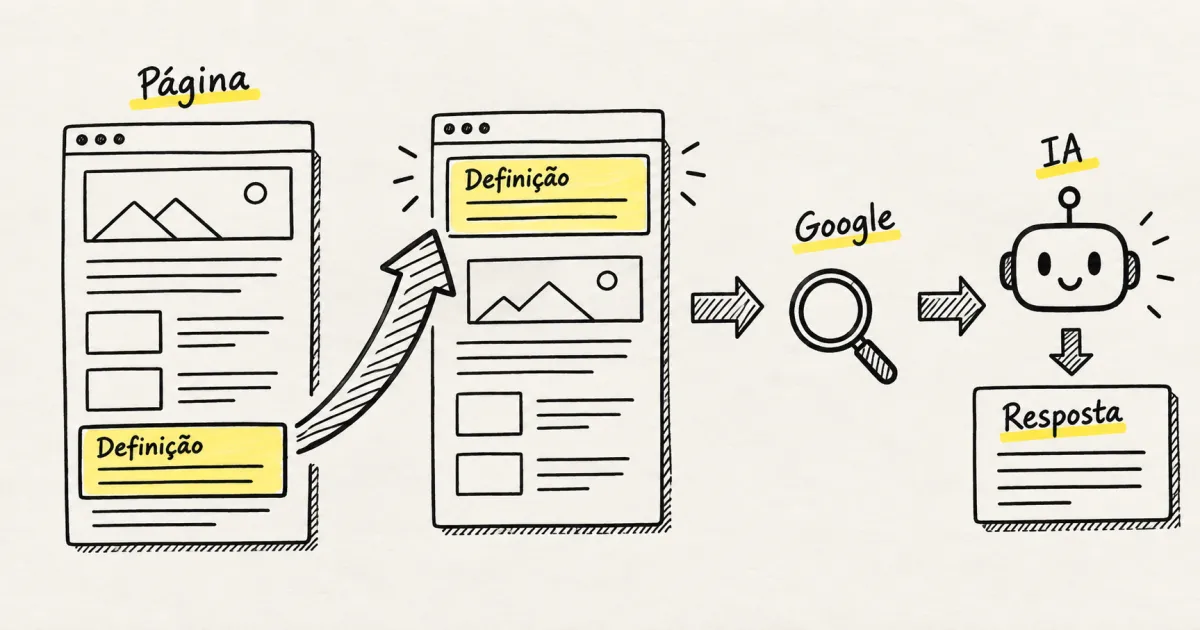
O checklist AEO para auditar uma página que ranqueia no Google e nunca aparece em respostas de IA
Use o checklist AEO com 12 itens para auditar páginas que ranqueiam no Google, mas não aparecem em respostas de IA.
-
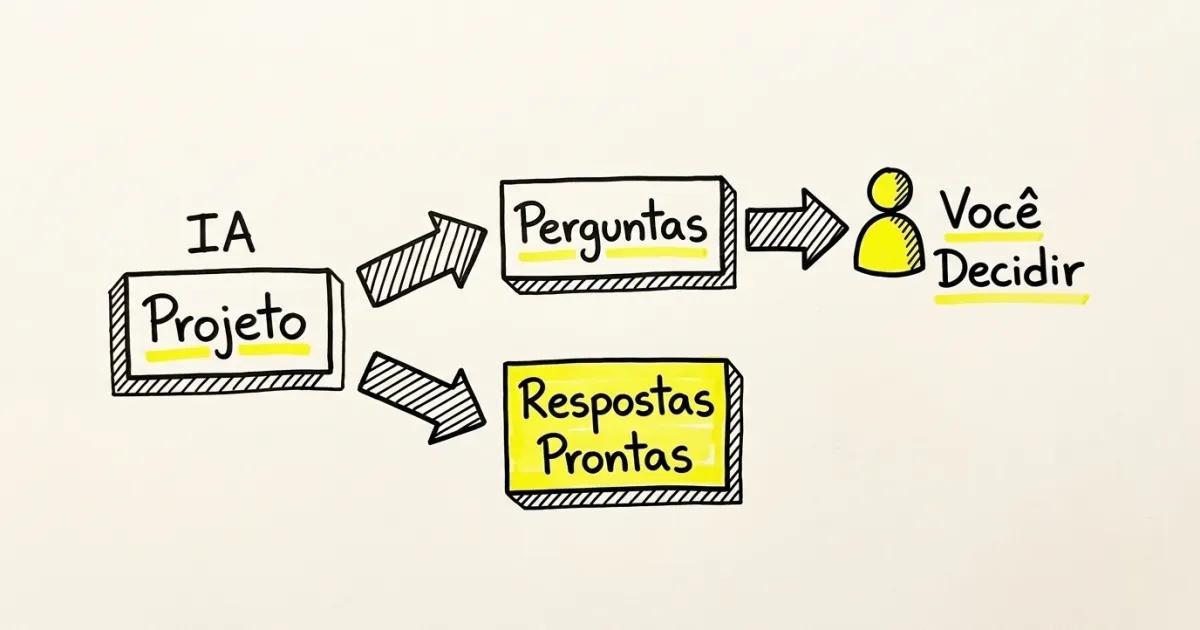
IA para pensar projeto: perguntas antes do primeiro commit
Use IA para pensar projeto com uma entrevista em quatro blocos para definir problema, usuário, limites e entregável antes do primeiro commit.
-
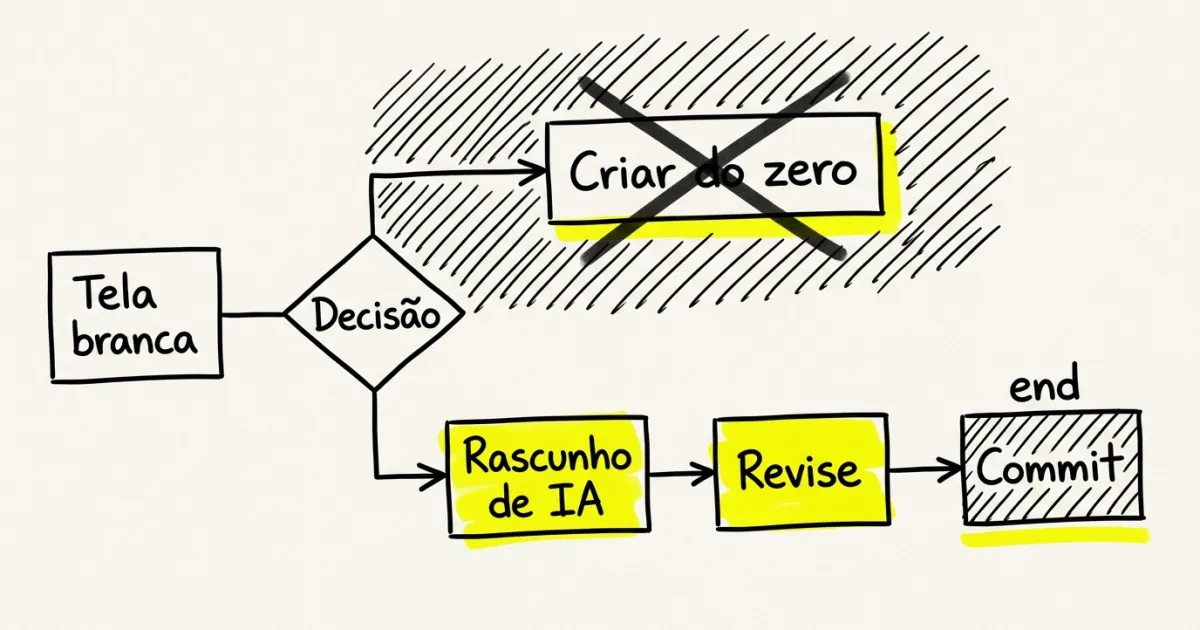
Síndrome da tela branca: como a IA ajuda a começar do zero
Veja como a IA ajuda a superar a síndrome da tela branca com rascunhos pequenos e revisão de código antes do commit.
-
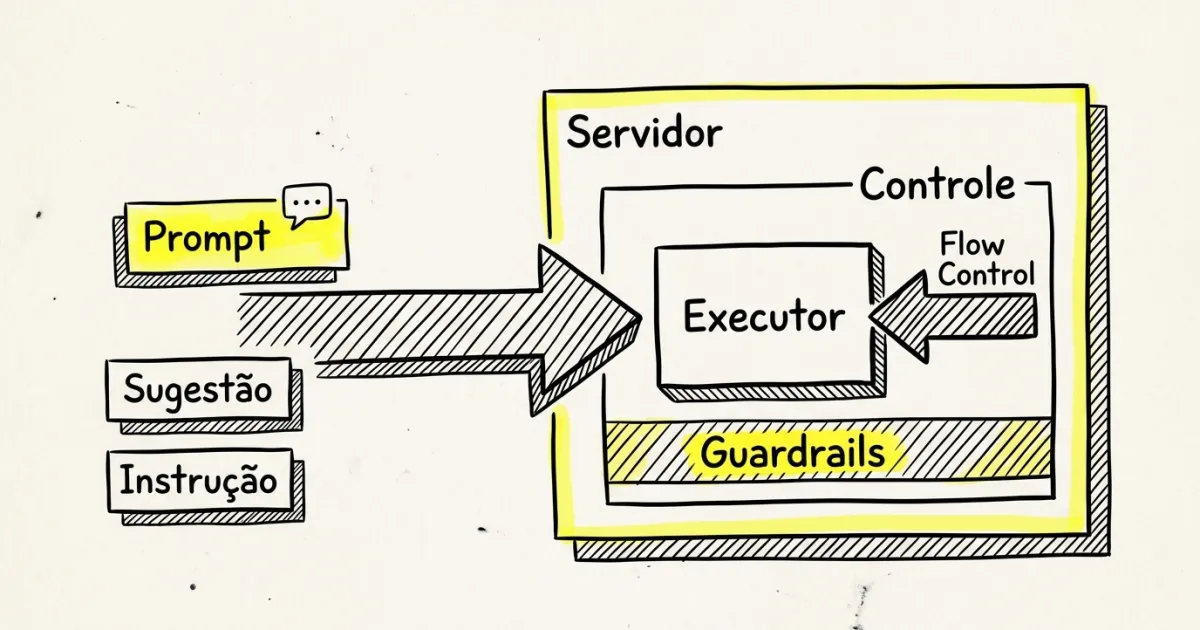
Guardrails multi-tenant rodam no seu servidor, não no prompt
Guardrails multi-tenant devem operar no executor, com allowlists, limites, idempotência e auditoria para impedir ações indevidas.
-
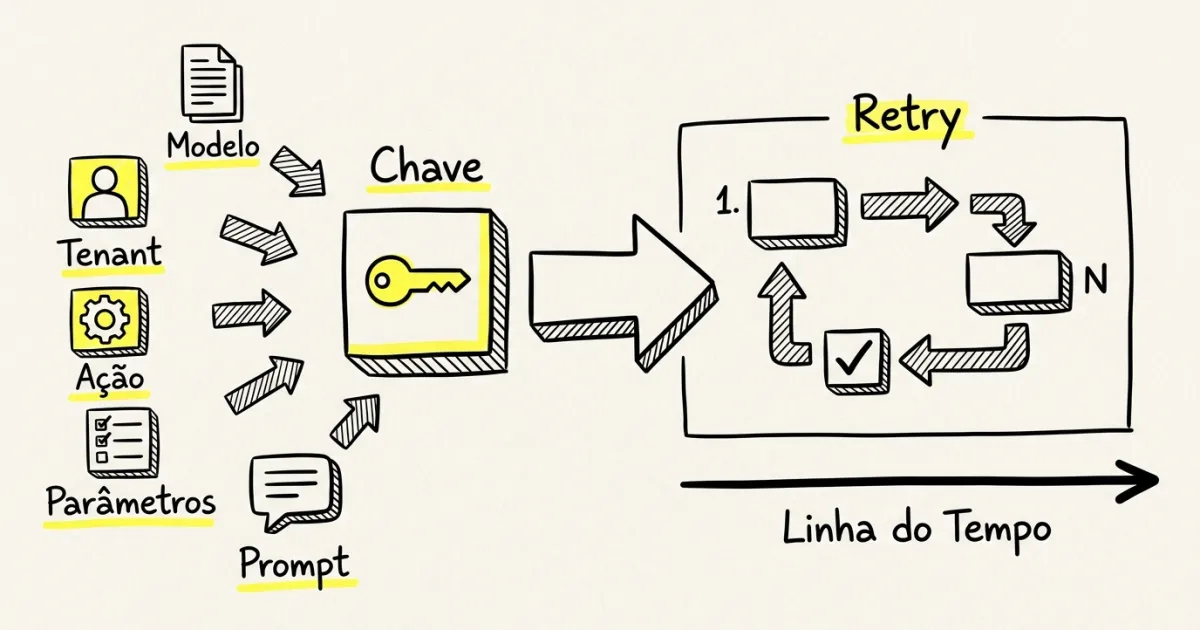
A chave de idempotência não pode nascer dentro da tentativa
Sua chave de idempotência não pode ser gerada na tentativa. Use UUID ou HMAC para evitar duplicações em requisições repetidas.
-

Spec-driven development, não só vibe coding
Spec-driven development: o que é, como Spec Kit e Kiro implementam o fluxo, e o que mudou em 2026, do agentic engineering ao spec correctness.
-

Kill switch de agente: o circuit breaker que não espera o erro chegar
Kill switch de agente: a matriz de disparo com os cinco sinais que param um agente em loop, com config de gateway e regra de rearme.
-

Prompt caching via API: a alavanca de custo que mora no formato do prompt
Prompt caching via API: escrever custa 25% a mais, ler custa 10%. O layout de prompt que vira economia real na Anthropic, OpenAI e Gemini.
-

LLM gateway, não só API gateway: a política que decide quem atende cada request
LLM gateway não é só API gateway com outro nome. A política de roteamento com gatilho, trava de fallback e teto de gasto por classe.
-

Cost attribution por feature, workflow e tenant: de qual bolso saiu cada token
Cost attribution de LLM: o contrato de atribuição que amarra cada request a feature, workflow e tenant, do gateway ao relatório por tenant.
-

Token budget por agente: o rate limiter que protege o seu orçamento
Token budget por agente: rate limit de provedor controla taxa, não gasto. Como impor teto de custo por request, sessão, agente e tenant.
-

Latência, qualidade, custo e confiabilidade: o mapa do stack de inferência
Latência, qualidade, custo e confiabilidade: os quatro eixos que todo knob do stack de inferência move, com preços e limites verificados em 2026.
-

Context engineering, não só prompts longos
Os quatro modos de falha de contexto e as táticas que mantêm agentes de IA confiáveis, além do prompt.
-

O efeito snowball: por que a mensagem 50 pesa 6x na janela de contexto
Cada mensagem pesa mais na janela de contexto. A fórmula do custo quadrático e um HUD de statusline pra ver a bola de neve crescer.
-

Harness engineering, não só prompt engineering
Harness engineering: guias, sensores e correções no ambiente tornam agentes de código mais confiáveis, além do prompt.